
读懂任务包、费用预览、断点继续与复核文件,先用小样本和 dry-run 开始。dry-run 与复核文件比口号更重要。
来源 · dtduc-git · 开源导读
2026-09-21 · 编辑整理,未调用真实模型
背景 / 问题
Section titled “背景 / 问题”你只是想给一张表增加几个判断列,却很快遇到重复请求、进度恢复、费用、失败和人工修改。jev-table 的价值是把这些表格处理环节放进一个命令行工具,而不只是循环调用一次模型。
本页依据项目 README 解释运行方法。开源代码和任务包、样例数据的许可需要分别看;我们没有在你的账户上安装或运行它。
从任务包到可复核输出 CSV + pack → dry-run → 主动授权调用 → 结果/错误/复核 → 保留 ID 与版本
不把估算当账单,不把阈值当准确率。
-
先检查项目当前 Python/uv 要求、Apache-2.0 代码许可与示例包许可。
-
一份小 CSV 与匹配字段名的 pack.yaml。
-
dry-run 不发送模型请求;真实运行需要授权密钥,可能产生费用。
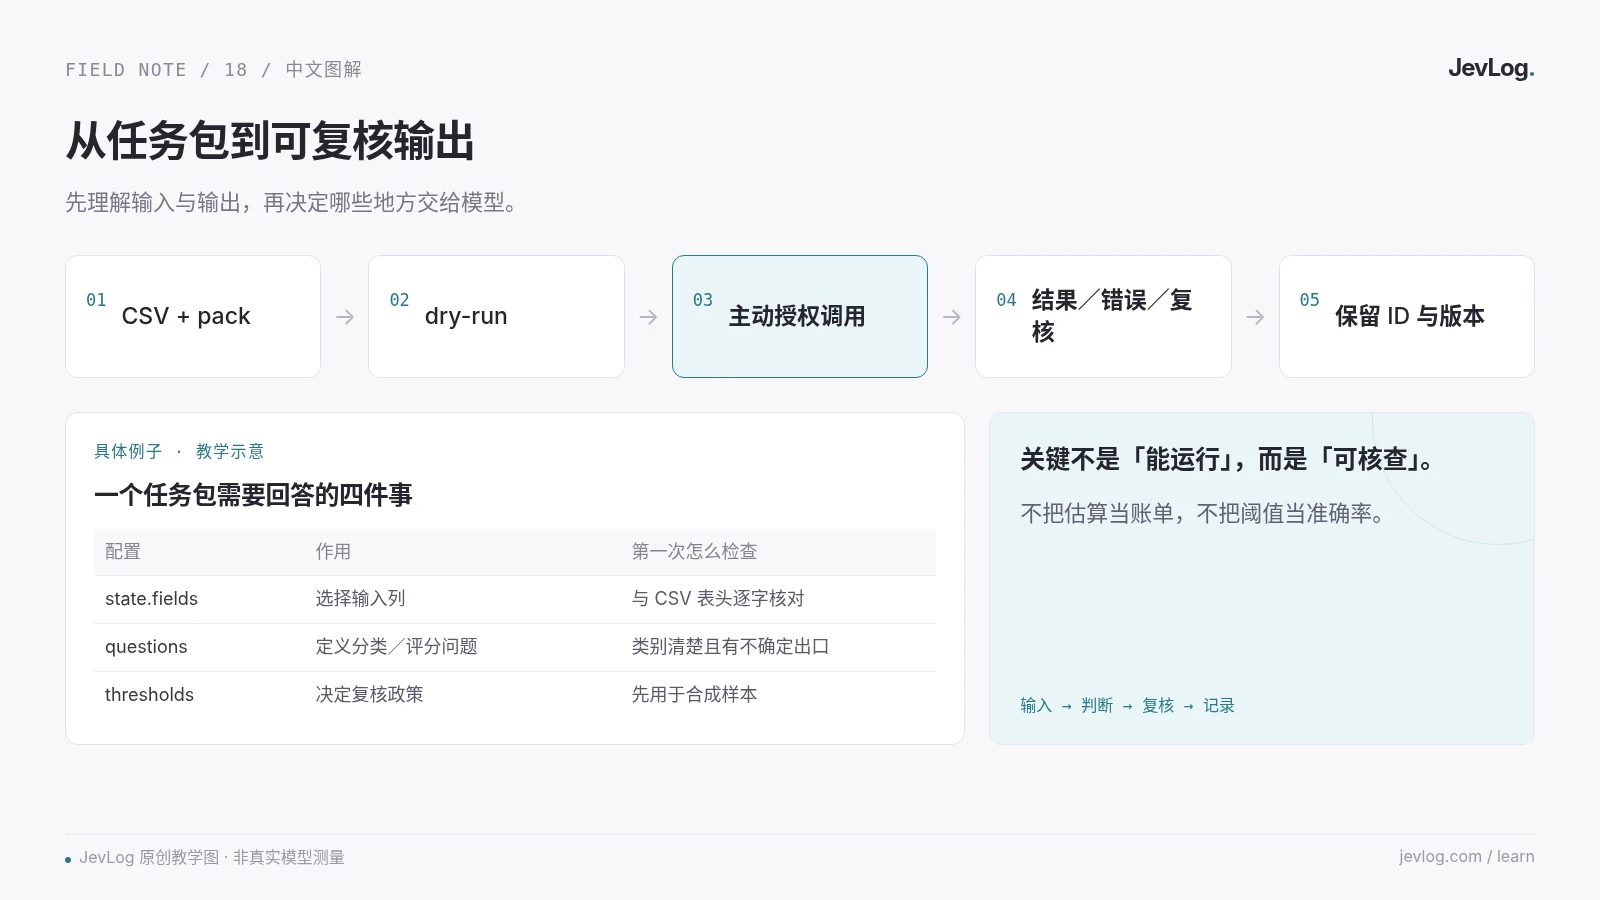
JevLog 原创教学示意,不是原作者产品截图或真实模型测试结果。
1. 任务包先决定问什么
Section titled “1. 任务包先决定问什么”README 用 YAML 描述 state.fields、问题、类别或等级和阈值。CSV 列名必须与 state.fields 对应。规则不是藏在代码里的一段随意提示,而是可版本化的配置。
从作者随包示例开始,不把客户完整导出直接用于第一遍实验。
2. dry-run 看的是计划,不是预测结果
Section titled “2. dry-run 看的是计划,不是预测结果”执行文档中的示意命令,文件名应换成你实际准备的 CSV 与任务包。先检查行数、字段和估算范围。
费用预览是事前估计,不是账单;也不证明模型会判断正确。
uvx jev-table messages.csv --spec pack.yaml --dry-run3. 理解成功、待复核和错误怎样保留
Section titled “3. 理解成功、待复核和错误怎样保留”项目把标签、相关信号、review 与 error 等信息放进输出,并提供待修正记录。阈值未设置、结果不满足条件或无法明确处理时应保持可见。
决定开始真实请求前,再检查密钥、端点、预算与模型版本。不要把去掉 –dry-run 的命令当成纯离线操作。
4. 复核以后,检查能否恢复原始业务记录
Section titled “4. 复核以后,检查能否恢复原始业务记录”保持 ID 与原文件,比较处理、失败、复核数量。重复文本请求可以去重,但输出仍需对应每个输入记录。重试与断点继续是否按预期工作,要先用小样本验证。
把人工修改作为可复用测试案例的候选,涉及隐私和数据许可时先处理权限,不把客户原始文本直接放进公开任务包。
一个任务包需要回答的四件事
这里解释配置职责,不代替项目完整 YAML 规范。
| 配置 | 作用 | 第一次怎么检查 |
|---|---|---|
| state.fields | 选择输入列 | 与 CSV 表头逐字核对 |
| questions | 定义分类/评分问题 | 类别清楚且有不确定出口 |
| thresholds | 决定复核政策 | 先用于合成样本 |
| 版本与输出 | 允许回溯和恢复 | 保存包、模型与原始 ID |
命令源于项目 README;JevLog 未发起真实调用。
完成标准是一张可回查的结果表及明确的待复核/错误记录。它不是天然无人值守系统;预算、数据权限和最后的业务使用仍由你负责。
- dry-run 成功不是线上模型质量通过。
- 不直接复制别人任务包阈值当生产政策。
- 当前账户、端点与模型可用性要在运行前核对。
- 你能说明输入来自哪里、哪些字段会参与处理。
- 你保留了原始记录及不确定、失败和人工修改的结果。
- 你能区分本地练习、作者演示与自己真实调用后的测试。
来源边界:依据所列公开来源整理;本站未复现演示。分类结果需人工复核,不会自动执行。
有去重会不会删客户记录?
Section titled “有去重会不会删客户记录?”应区分去重推理与删除业务记录。运行后核对所有原始 ID,不能仅看请求数。
能改成自己的网关吗?
Section titled “能改成自己的网关吗?”项目提供端点相关设置,但兼容性与账户权限需要单独检查,不能只改 URL 就假设一致。