
用 4 条合成记录和自定阈值拆分建议与待复核结果;按 ID 核对数量、原因和原文,再由人工确认,示例不代表模型准确率。
来源 · JevLog 原创 · 本站原创
2026-09-21 · 编辑整理,未调用真实模型
背景 / 问题
Section titled “背景 / 问题”判断结果可能低信号、缺字段或请求失败。用 4 条合成记录演练分流,核对总行数与原始 ID;0.8 只是脚本示例阈值,不是 Jev 实测或通用标准。
- 使用 examples/normalized_results.csv;需要 Python 3.10+。
- 输入列包含 id、text、label、confidence,真实接口要先通过适配层映射。
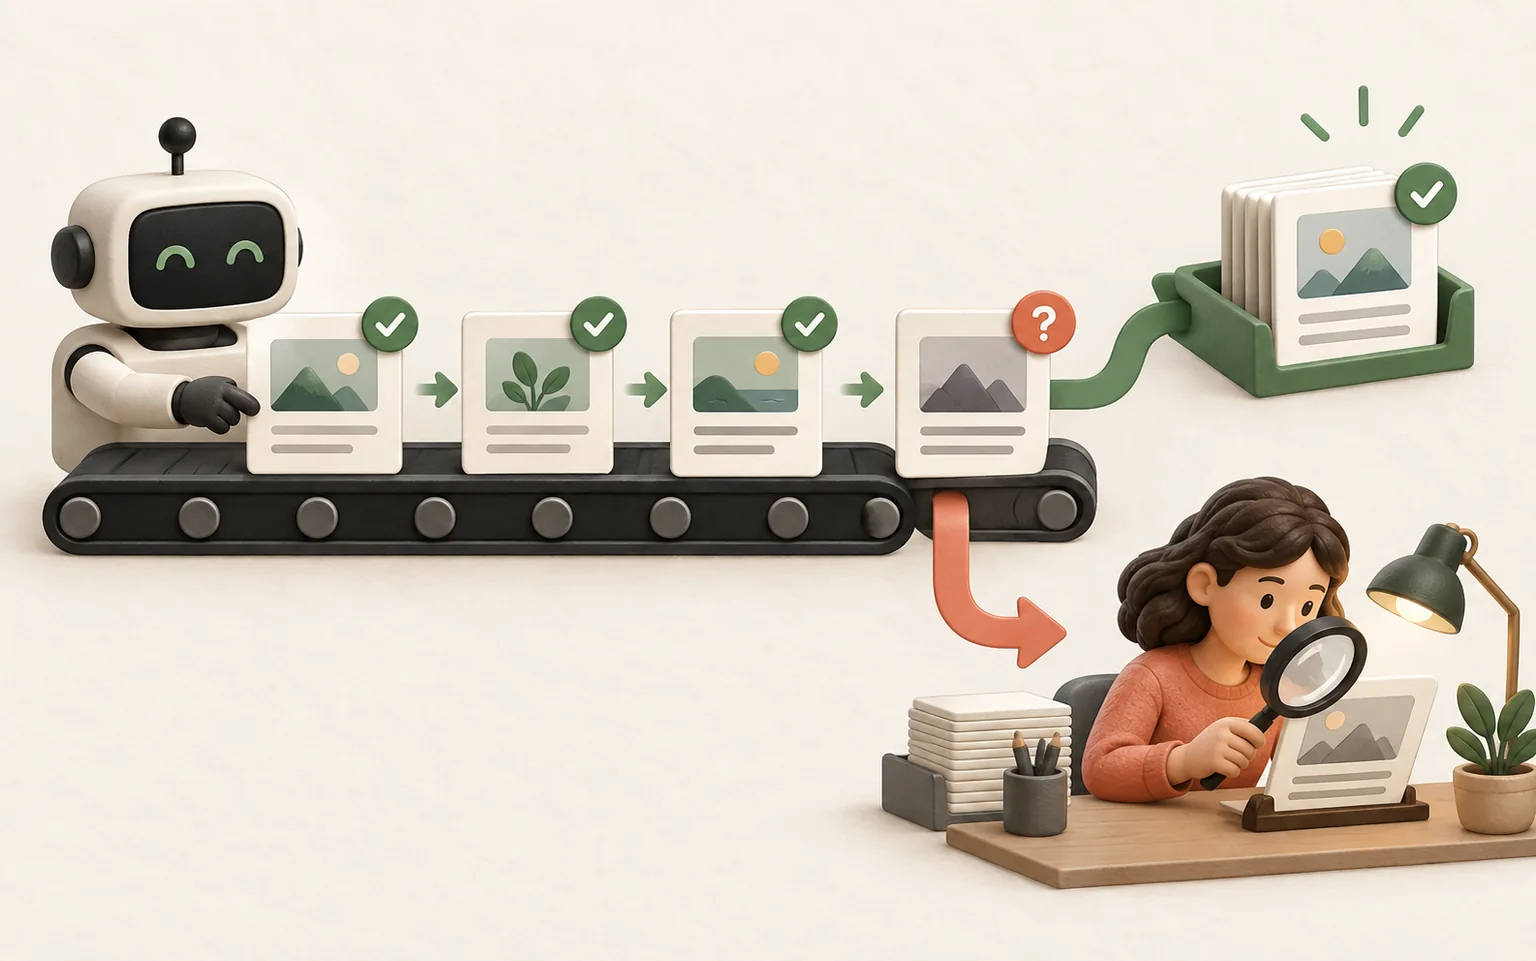
低信号、缺字段和异常结果进入人工复核队列。AI 概念插画。
1. 先确认你拿到的分数到底代表什么
Section titled “1. 先确认你拿到的分数到底代表什么”先确认分数字段来源与范围;脚本只按既有归一化数值分流,不校准概率或准确率。
2. 显式提供练习阈值
Section titled “2. 显式提供练习阈值”给定练习阈值;缺失或非法分数进 review,脚本只处理本地 CSV,不发请求或改系统。
python scripts/split_review_queue.py examples/normalized_results.csv --threshold 0.8 --output-dir review-demo3. 读两个结果文件,核对数量守恒
Section titled “3. 读两个结果文件,核对数量守恒”核对两份文件各 2 条、共 4 个原始 ID;逐条查看原因,suggested 仍待人批准。
4. 把人工修正作为单独的一次事件
Section titled “4. 把人工修正作为单独的一次事件”人工确认或改标时写明理由,并保留原文、初始建议、复核人和时间;不要只存最终标签。
5. 既检查复核队列,也抽查看似可靠的建议
Section titled “5. 既检查复核队列,也抽查看似可靠的建议”抽查 suggested 并用标注样本选阈值;批次或规则变化后重评,重要操作仍需人工或规则批准。
练习可用样本:下载 normalized_results.csv(CSV Studio / 本地练习;非本站实测结果)。
你能按 ID 核对每条记录的去向与复核原因,并区分流程分流和模型准确率。
- 你能说明输入来自哪里、哪些字段会参与处理。
- 你保留了原始记录及不确定、失败和人工修改的结果。
- 你能区分本地练习、作者演示与自己真实调用后的测试。
复核比例越低越好吗?
Section titled “复核比例越低越好吗?”不一定。漏过错误与人工成本要同时看,减少人工比例不能以隐藏错误为代价。